L’orchestration des conteneurs Kubernetes s’est imposée comme une référence pour piloter des plateformes data modernes. Toutefois, réussir un déploiement on-premise haute disponibilité reste un défi, que ce soit pour fiabiliser les environnements de production, maîtriser les coûts ou répondre à des exigences réglementaires. Chez iiiData, expert en projets Data et BI, nous accompagnons nos clients sur toutes les étapes de l’industrialisation de leur stack open source, du design d’architecture à l’automatisation du monitoring. Ce guide s’adresse aux équipes techniques qui souhaitent installer Kubernetes on-premise avec kubeadm, bâtir un cluster robuste et garantir la pérennité de leurs opérations data critiques.

Anticiper les enjeux d’un cluster Kubernetes on-premise
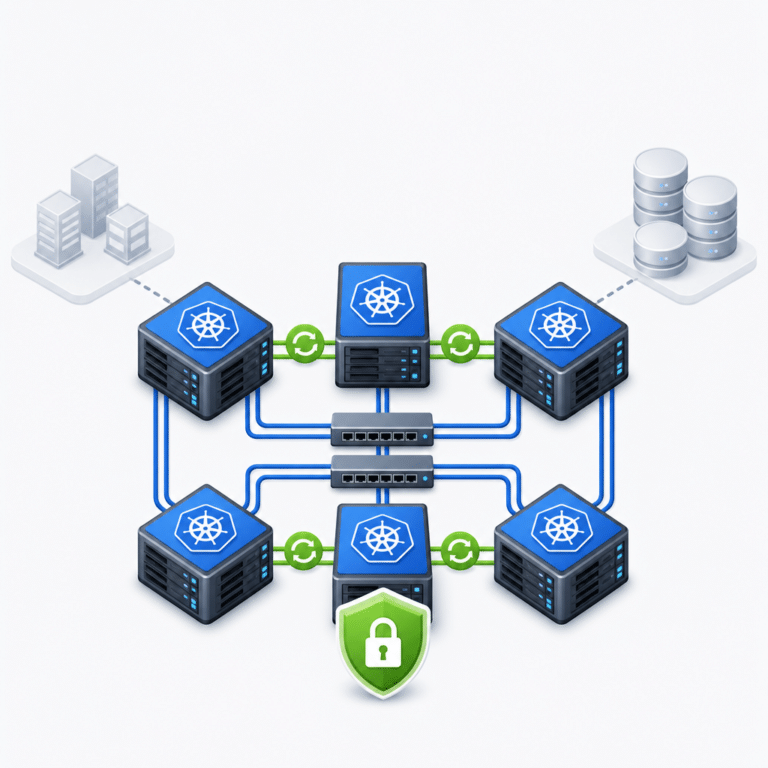
L’adoption de Kubernetes on-premise répond à plusieurs impératifs : sécurité, maîtrise des données sensibles, personnalisation de l’architecture et souveraineté des usages métiers. Contrairement aux services managés du cloud, l’installation sur son propre datacenter implique d’en maîtriser chaque paramètre, du hardware à la couche réseau.
Un cluster on-premise bien conçu permet :
- une résilience accrue vis-à-vis des défaillances réseau ou matérielles,
- une proximité des traitements data avec les systèmes métiers existants,
- un pilotage fin de la sécurité et de l’accès aux données,
- une intégration facilitée à l’écosystème open source (Airflow, PostgreSQL, DBT…),
- une optimisation des coûts pour des charges stables ou critiques.
Cependant, il faut s’astreindre à une méthodologie solide pour garantir la fiabilité et la scalabilité de l’infrastructure : conception du plan d’adressage IP, choix du matériel, redondance du réseau, anticipation des montées en charge, sauvegardes et procédures de restauration.
Installer Kubernetes avec kubeadm : prérequis et bonnes pratiques
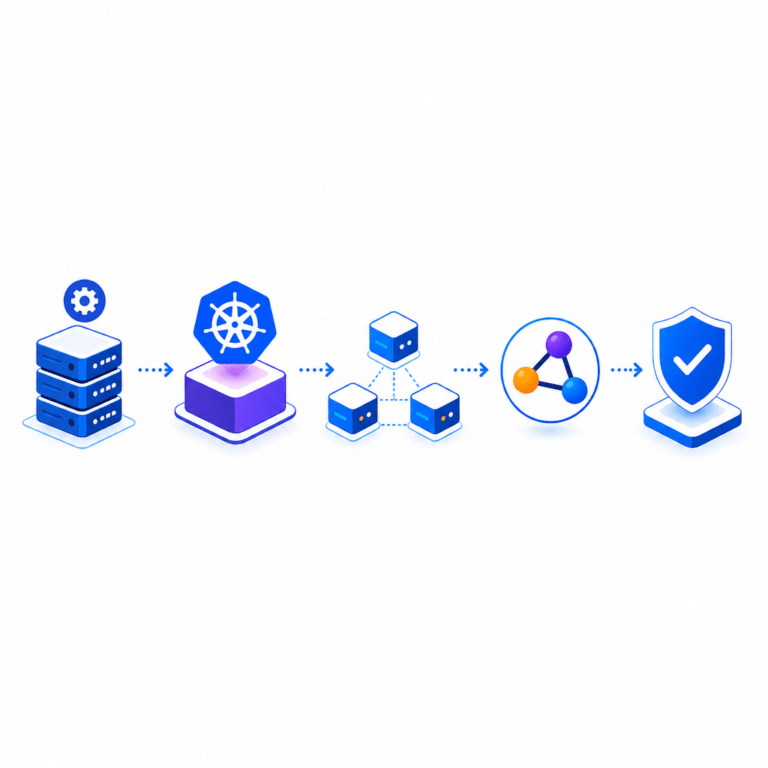
kubeadm est l’outil de référence pour automatiser le bootstrap d’un cluster Kubernetes sur site. Il facilite l’initialisation du control plane, la configuration des nœuds de calcul (workers), le paramétrage du stockage et la sécurisation du cluster.
Avant d’installer Kubernetes via kubeadm, il convient de :
- disposer de machines physiques ou virtuelles sous Linux (Ubuntu, CentOS ou Red Hat Enterprise Linux sont des choix éprouvés),
- préparer une configuration réseau stable avec une résolution DNS interne fiable,
- ouvrir les ports nécessaires au fonctionnement des composants Kubernetes,
- installer les prérequis logiciels : containerd ou Docker, kubeadm, kubelet, kubectl,
- configurer le firewall et désactiver le swap afin d’assurer la performance du cluster.
Un exemple de bonnes pratiques : déployer au minimum trois nœuds maîtres pour garantir la haute disponibilité du control plane, et séparer les workers selon les types de workloads (data processing, BI, API, etc.). Assurez une homogénéité logicielle et matérielle entre les nœuds pour éviter les incohérences lors des mises à jour.
Guide étape par étape : démarrer son cluster Kubernetes HA avec kubeadm
Voici le déroulé clé pour réussir son installation :
- Préparation des nœuds : Mettez à jour le système, installez Docker/containerd, kubectl, kubeadm et kubelet sur chaque serveur.
- Initialisation du control plane : Sur le premier nœud, exécutez
kubeadm initavec l’option--control-plane-endpoint. Récupérez la commande token générée pour rejoindre les autres nœuds maîtres. - Ajout des nœuds masters et workers : Lancez sur chaque nouveau nœud la commande join correspondante (avec
--control-planepour un master, sinon worker). - Déploiement du réseau pod : Installez une solution CNI open source (Calico, Flannel, Cilium) pour gérer la couche réseau interne entre pods.
- Validation de la santé du cluster : Vérifiez l’état des composants (kubectl get nodes, get pods), configurez les taints et labels.
Astuce iiiData : centralisez les logs et métriques via Prometheus et Grafana dès le déploiement, afin d’anticiper toute dérive ou anomalie de performance dans le cluster.
Sécuriser et fiabiliser son cluster Kubernetes en production
Un cluster on-premise expose des surfaces d’attaque spécifiques : accès SSH, API, commutateurs réseaux, données sensibles sur disque… Il est essentiel de mettre en place des mesures de sécurité renforcées dès le design initial :
- isoler le réseau Kubernetes des autres segments métiers,
- utiliser des certificats et authentifications robustes sur l’API server,
- activer le RBAC pour limiter les droits sur les namespaces et ressources,
- planifier des sauvegardes régulières d’ETCD et des configurations critiques,
- monitorer en temps réel via des alertes Prometheus et logs centralisés (ELK, Loki…)
La haute disponibilité dépend aussi de la redondance matérielle et logicielle. Prévoyez plusieurs control planes sur des racks distincts, reproduisez la configuration sur un site secondaire pour garantir le plan de reprise d’activité. Nos experts iiiData recommandent également l’automatisation des déploiements (GitOps, ArgoCD) pour limiter les erreurs humaines.
Surveiller et maintenir efficacement son cluster Kubernetes
Le monitoring proactif est fondamental pour assurer la pérennité d’une stack data reposant sur Kubernetes. Cela passe par :
- la collecte temps réel des métriques système et applicatives (CPU, mémoire, réseau),
- le suivi de la disponibilité des pods critiques (ingestion, traitement, BI…),
- l’automatisation des alertes sur seuils pour réagir avant l’incident,
- des dashboards personnalisés pour visualiser les tendances historiques.
Des outils open source comme Prometheus, Grafana, ou encore Kube-state-metrics et Alertmanager sont incontournables pour assurer la supervision détaillée. L’intégration avec les outils de ticketing métiers facilite la gestion des incidents. iiiData intervient aussi pour former les équipes et définir les SLA adaptés à chaque usage data.
Installer et piloter un cluster Kubernetes haute disponibilité on-premise avec kubeadm est un projet ambitieux, mais indispensable pour les entreprises exigeant souveraineté, sécurité et performance de leurs plateformes data. L’expertise de iiiData permet d’orchestrer chaque étape : du design initial à l’automatisation de la supervision en passant par la sécurisation et le maintien en conditions opérationnelles. Franchir ce cap, c’est offrir à vos équipes une infrastructure robuste, évolutive et adaptée à vos enjeux métiers data, BI et IA.
📚 Pour aller plus loin
- Kubernetes : Installer kubeadm (documentation officielle)
- Kubernetes : Clusters HA (documentation Kubernetes)
- GitHub kubeadm
- Prometheus, solution de monitoring open source
- Red Hat : Introduction à Kubernetes

Transformez vos données en avantage concurrentiel.
iiiData accompagne les PME, ETI et grands groupes dans la conception de plateformes Data, BI, IA et automatisation basées sur les meilleures technologies Open Source.
Architecture • Data Engineering • BI • IA • Formation