Dans le monde des plateformes data modernes, une exigence s’impose : garantir agilité, fiabilité et scalabilité pour répondre aux besoins croissants de la transformation numérique. Kubernetes s’est imposé en quelques années comme la référence incontournable pour l’orchestration et le déploiement de solutions data cloud native. Pourquoi ce standard s’est-il imposé face à tant d’alternatives ? Comment facilite-t-il concrètement la gestion et la valorisation des données métier ? iiiData, expert en conception de plateformes data, accompagne les entreprises dans l’adoption de ces technologies de pointe. Pour en savoir plus sur leur expertise, consultez leur page dédiée aux architectures data innovantes.

Pourquoi Kubernetes s’impose dans l’écosystème data
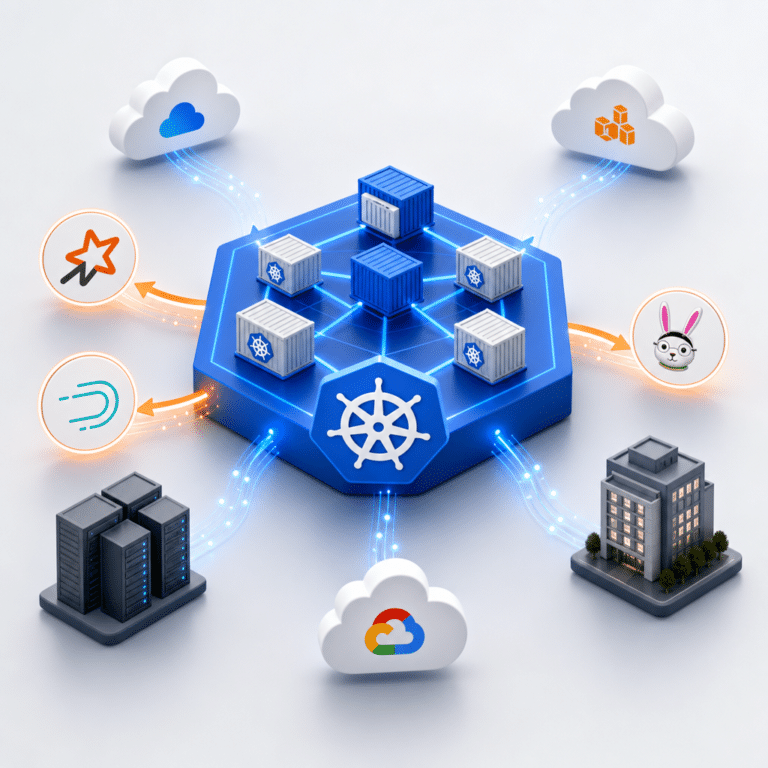
Depuis son lancement, Kubernetes transforme la manière dont les entreprises conçoivent, déploient et exploitent leurs architectures data. Porté par la Cloud Native Computing Foundation et soutenu par l’ensemble des principaux fournisseurs cloud, Kubernetes fournit un socle robuste pour l’exécution des conteneurs et des microservices.
Son atout clé ? La possibilité d’automatiser la gestion, la montée en charge et le cycle de vie complet des applications data, de la collecte à l’exposition de la donnée. Que ce soit pour héberger un cluster Spark, un entrepôt analytique open source (Trino, Druid) ou orchestrer des pipelines ELT complexes, Kubernetes standardise et industrialise l’approche.
Parallèlement, l’adoption massive de la philosophie « cloud native » encourage l’interopérabilité et la portabilité des workloads. Cela permet aux équipes data de déployer leurs applications sur n’importe quel cloud public, hybride ou sur site, sans se soucier des contraintes propres à chaque environnement.
L’orchestration centralisée pour des workloads data flexibles
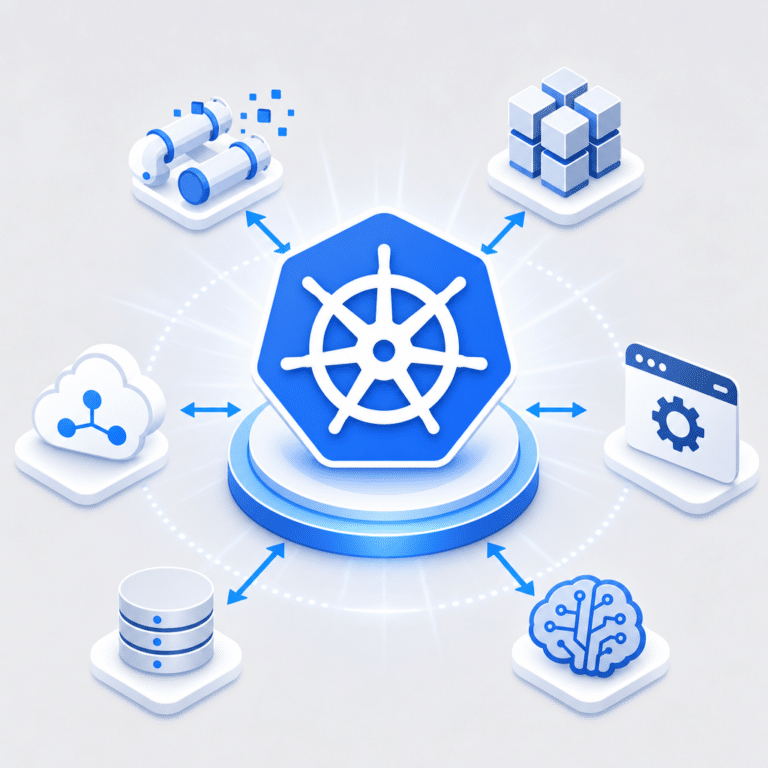
Ce qui fait la force de Kubernetes dans une stack analytique repose sur son cœur d’orchestration. Les jobs ETL, les traitements batch, les applications d’IA ou encore les API métiers sont pilotés à partir d’un point central, garantissant une gestion automatisée des défaillances, du scaling et du déploiement continu.
Grâce à la puissance des contrôleurs et à l’architecture déclarative (manifestes YAML), les déploiements deviennent répétables et fiables. Une équipe data engineering peut ainsi :
- Créer des pipelines reproductibles et versionnés ;
- Définir simplement des stratégies de scalabilité automatique (autoscaling) ;
- Isoler facilement les ressources pour chaque projet ou environnement ;
- Mettre à jour les composants sans interruption de services critiques.
Par exemple, iiiData a accompagné un acteur de la logistique dans la migration de ses traitements Data Science sur Kubernetes, rendant possible le lancement à la volée de centaines d’expériences en parallèle, avec une gestion fine des coûts et des performances.
Observabilité et monitoring natifs pour la fiabilité data
La fiabilité d’une plateforme data se juge à sa capacité à garantir disponibilité, traçabilité et résolution rapide des incidents. Kubernetes intègre nativement des solutions d’observabilité comme Prometheus, Grafana ou Jaeger, facilitant le monitoring temps réel et l’analyse des métriques.
Cette visibilité étendue s’applique à l’ensemble des composants d’une stack data :
- Suivi de l’utilisation CPU, RAM et stockage pour chaque traitement analytique ;
- Alerting automatique en cas de défaillance de pipeline ;
- Traçabilité complète des exécutions pour les équipes MLOps ou DataOps ;
- Intégration rapide avec des outils open source de pilotage (ELK, Loki, etc.).
Cet écosystème favorise la mise en place de pratiques SRE et l’automatisation des processus de remédiation, essentiels pour des déploiements à grande échelle ou soumis à des SLAs exigeants.
Eco-système open source et extensibilité à l’infini
Kubernetes s’est hissé au rang de standard grâce à un écosystème open source riche et une extensibilité sans précédent. Il s’interface nativement avec les principaux outils de data engineering : Spark Operator, Airflow, Kafka, DBT, Superset, Prometheus, etc.
Les opérateurs Kubernetes dédiés à la data permettent d’automatiser quasiment toute la chaîne de valeur, depuis le provisionnement d’un data lake jusqu’à l’entraînement de modèles IA. Cette extensibilité favorise l’innovation continue, sans dépendance vis-à-vis d’un unique éditeur ou cloud provider.
iiiData privilégie une approche modulaire et interopérable, garantissant à ses clients la possibilité de faire évoluer leur plateforme au rythme des innovations du marché, tout en maîtrisant leurs coûts d’exploitation.
Les défis et bonnes pratiques pour une adoption réussie
Malgré sa puissance, Kubernetes présente des défis lors de son adoption dans des contextes data :
- Maîtrise de la configuration réseau et du stockage persistant ;
- Gestion fine des droits d’accès et de la sécurité des données ;
- Montée en compétence des équipes engineering sur les pratiques DevOps et DataOps.
Un accompagnement par des experts comme iiiData permet de :
- Sélectionner une architecture adaptée (cloud, hybride, on-prem) ;
- Industrialiser les pratiques CI/CD et la gestion multi-environnements ;
- Automatiser le déploiement initial et le monitoring pour garantir une montée en charge maîtrisée.
En misant sur la formation et le support, les organisations peuvent accélérer concrètement leur transformation data tout en évitant les écueils fréquents des déploiements complexes.
La domination de Kubernetes dans l’univers des plateformes data n’est pas un effet de mode, mais le reflet de sa capacité à combiner agilité, robustesse et ouverture. En permettant de déployer, orchestrer et surveiller l’ensemble d’une stack analytique de façon industrialisée et évolutive, il constitue aujourd’hui une pièce maîtresse de toute stratégie data moderne. Pour tirer parti de tout le potentiel de Kubernetes et garantir la réussite de vos projets, l’accompagnement d’experts comme ceux d’iiiData représente un atout décisif.
📚 Pour aller plus loin
- Documentation officielle Kubernetes
- Cloud Native Computing Foundation
- Apache Airflow Documentation
- Guide Prometheus Monitoring
- Documentation Apache Spark

Transformez vos données en avantage concurrentiel.
iiiData accompagne les PME, ETI et grands groupes dans la conception de plateformes Data, BI, IA et automatisation basées sur les meilleures technologies Open Source.
Architecture • Data Engineering • BI • IA • Formation