Le déploiement de plateformes data et analytics en environnement de production nécessite des fondations robustes et évolutives. Aujourd’hui, Kubernetes s’impose comme l’orchestrateur de référence pour la conteneurisation et l’industrialisation des solutions open source dans le domaine Data & BI. Pourtant, exploiter Kubernetes à l’échelle demande une approche rigoureuse, autant en termes d’observabilité que de sécurité et de haute disponibilité. Spécialiste de l’intégration de stacks data modernes, iiiData revient ici sur les meilleures pratiques pour garantir un environnement Kubernetes fiable, sécurisé et prêt pour les enjeux métiers.
Adopter une architecture résiliente pour vos workloads data
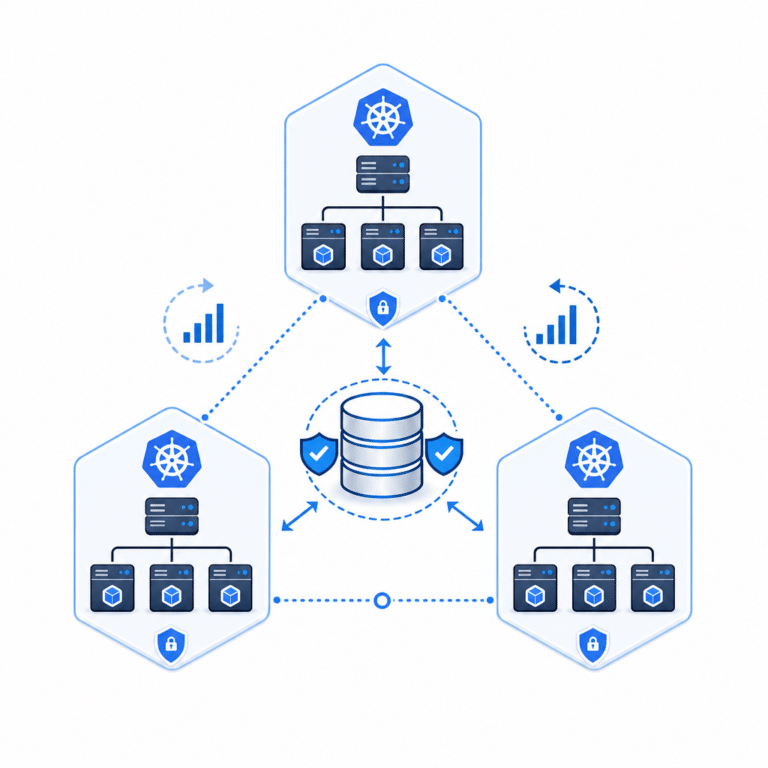
La conception d’une architecture Kubernetes résiliente est un facteur déterminant pour la réussite d’un projet data en production. Un cluster bien dimensionné garantit la continuité de service des plateformes analytiques, même en cas de panne ou de montée en charge imprévue.
Pour y parvenir, il convient d’appliquer les principes suivants :
- Multi-zones de disponibilité : Répartir les nœuds maîtres et workers sur plusieurs zones pour éviter le SPOF (Single Point of Failure).
- Autoscaling : Configurer les mécanismes d’ajout dynamique de resources (Horizontal Pod Autoscaler, Cluster Autoscaler) pour s’ajuster automatiquement à la charge.
- Utilisation de Storage Classes redondantes : Sécuriser la persistance des données analytiques même en cas de défaillance matérielle.
Par exemple, une plateforme de BI reposant sur des outils open source tels que Superset ou Metabase bénéficiera ainsi d’une haute disponibilité, indispensable à la prise de décision en temps réel. L’expérience d’iiiData démontre que la mise en place d’un DRP (Disaster Recovery Plan) adapté au contexte Kubernetes est un investissement crucial dès la phase de conception.
Sécuriser l’ensemble du cycle de vie applicatif sur Kubernetes
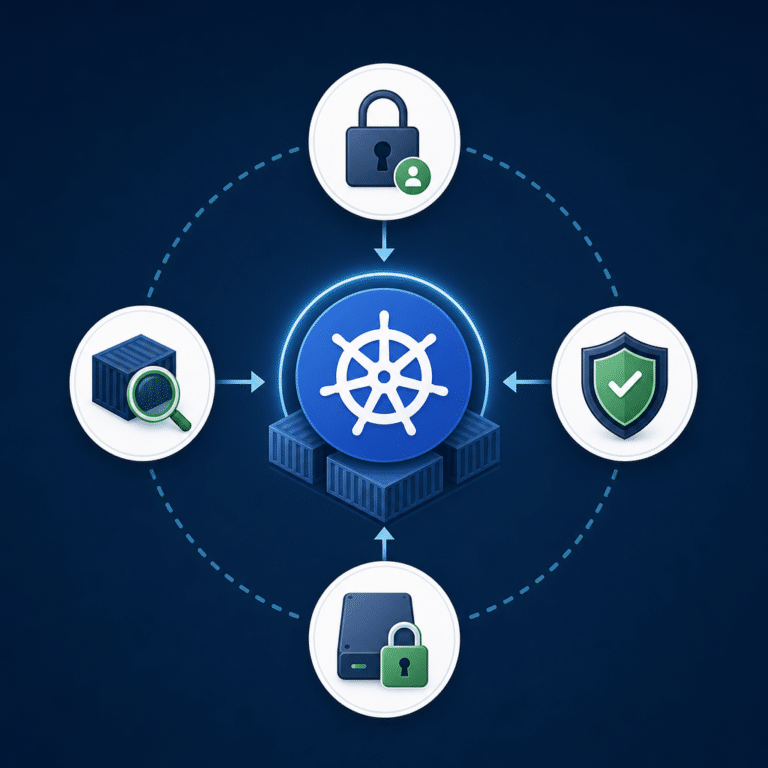
La sécurité est au cœur des préoccupations des projets data, notamment lorsque des données sensibles transitent par la stack. Exploiter Kubernetes en production implique d’étendre la sécurité bien au-delà du zonage réseau classique.
Les équipes data pourront renforcer leur posture en :
- Appliquant la gestion fine des accès (RBAC, IAM) pour circonscrire les droits au minimum nécessaire.
- Mettant en œuvre des politiques réseau (Network Policies) pour contrôler avec précision les flux entre pods et services.
- S’intégrant aux outils de scanning d’images (Trivy, Kube-hunter) afin de détecter les failles dès la phase CI/CD.
- Chiffrant systématiquement les volumes persistants et en transit (TLS, secrets K8s).
Dans la pratique, des audits réguliers permettent d’anticiper les évolutions réglementaires (RGPD, ISO 27001) tout en réduisant les risques d’exposition. L’accompagnement par une structure experte comme iiiData permet de sécuriser chaque étape, du provisioning au monitoring opérationnel de la plateforme analytics.
Mettre en place une observabilité avancée pour piloter la stack data
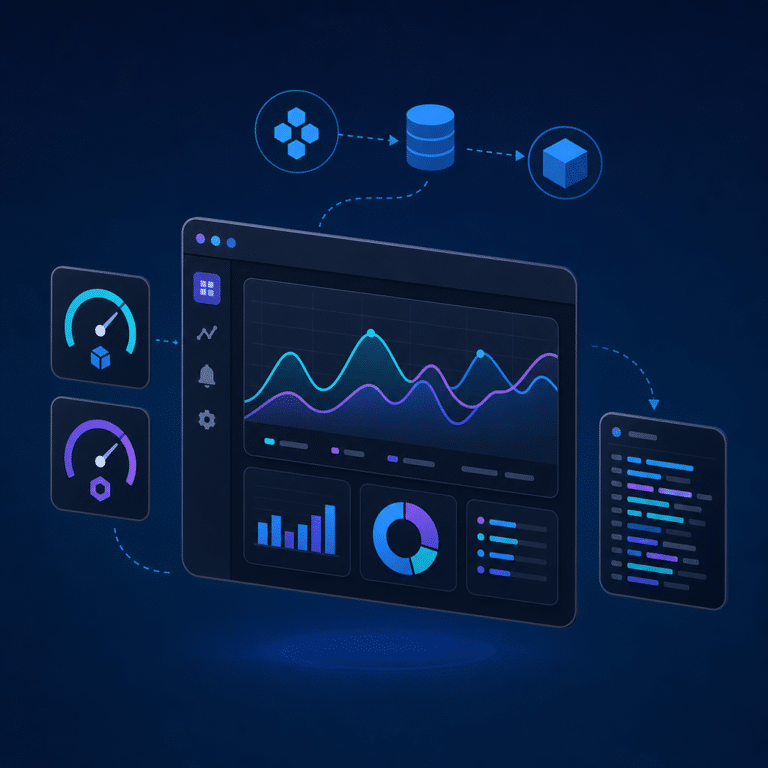
Une supervision avancée du cluster est indispensable pour garantir la fiabilité et l’optimisation continue de votre stack chez iiiData. Au-delà des métriques standards de Kubernetes, il s’agit de croiser différents niveaux d’observabilité :
- Monitoring de la santé des pods et nodes via Prometheus, Grafana ou Datadog.
- Collecte des logs unifiés (ELK/EFK) pour accélérer le troubleshooting applicatif et infrastructurel.
- Traçabilité des requêtes data, afin de corréler performance et expérience utilisateur sur chaque composant BI.
L’implémentation d’alertes personnalisées, la remontée des métriques métiers spécifiques (temps de rafraîchissement, taux d’échec des jobs ETL) et l’analyse proactive d’incidents accompagneront un pilotage robuste et réactif de l’écosystème data. Une plateforme bien monitorée optimise la qualité de service rendue aux directions métiers.
Automatiser le déploiement et les tests pour fiabiliser la production
L’un des atouts majeurs de Kubernetes réside dans l’automatisation de la livraison logicielle, notamment dans les contextes Cloud Native et open source. Une chaîne CI/CD (GitLab, ArgoCD, Flux) permet de déployer, tester et valider rapidement chaque évolution de la stack data, tout en limitant considérablement les erreurs humaines.
Les meilleures pratiques pour fiabiliser les workflows de déploiement incluent :
- Des tests automatisés (lint, intégration, tests de charge) dès la phase de build des images containers.
- L’usage de Helm charts ou de manifestes Kustomize pour garantir la reproductibilité des environnements.
- Le versioning systématique des configurations d’infrastructure « as code ».
Un exemple concret souvent rencontré par iiiData : la mise à jour planifiée d’un pipeline ETL – orchestré par Airflow sur Kubernetes – se fait sans interruption, grâce au déploiement canari et au rollback automatisé. Cet automatisme sécurise l’exploitation des données tout en accélérant le cycle d’innovation.
Exploiter Kubernetes pour héberger une stack data de production implique une maîtrise des enjeux d’architecture, de sécurité, d’observabilité et d’automatisation. L’application de ces bonnes pratiques, combinée à l’expérience terrain d’un expert tel qu’iiiData, permet de délivrer une plateforme fiable, performante et pérenne, prête à soutenir la croissance et l’innovation métier. Adapter ces fondamentaux à votre contexte spécifique est la clé pour tirer le meilleur parti de l’écosystème Kubernetes dans vos projets data.
📚 Pour aller plus loin
- Documentation officielle de Kubernetes
- Guide officiel Prometheus
- Elastic Stack Documentation
- Cloud Native Computing Foundation – Projets open source
- Helm : documentation des Charts pour Kubernetes

Transformez vos données en avantage concurrentiel.
iiiData accompagne les PME, ETI et grands groupes dans la conception de plateformes Data, BI, IA et automatisation basées sur les meilleures technologies Open Source.
Architecture • Data Engineering • BI • IA • Formation