Face à la multiplication des sources d’information et à l’explosion des volumes de données, les Entreprises de Taille Intermédiaire (ETI) font face à un défi stratégique : comment structurer une architecture data évolutive permettant de valoriser pleinement la donnée métier ? Chez iiiData, nous accompagnons les ETI dans la conception de plateformes data ouvertes, fiables et souveraines, grâce à des solutions modernes, flexibles et majoritairement basées sur l’open source. Dans cet article, nous proposons un panorama des principes, outils et choix d’architecture à privilégier pour bâtir une plateforme data robuste, adaptée aux enjeux de gouvernance, de BI et d’automatisation propres aux ETI.
Les enjeux de la plateforme data pour une ETI
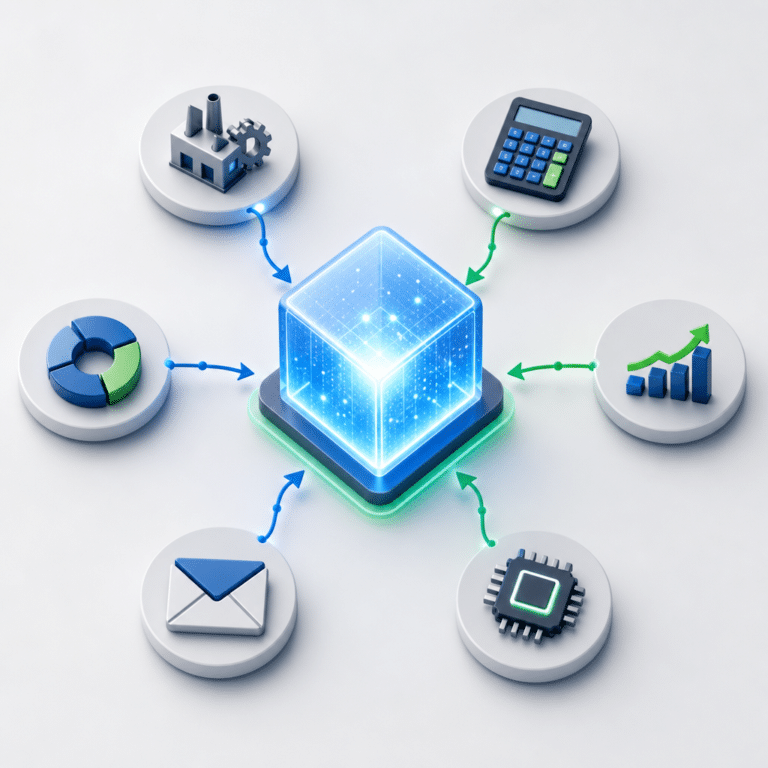
Les ETI gèrent des volumes de données croissants issus de multiples métiers : ERP, CRM, production, finance, marketing ou encore IoT. La diversité de ces sources accentue la complexité du gouvernement de la donnée et l’aspect critique de la fiabilisation de l’information. L’enjeu principal est de transformer ces données hétérogènes en actifs décisionnels fiables et valorisables, tout en maîtrisant les coûts et en garantissant la souveraineté des informations stratégiques.
Contrairement aux grands groupes, les ETI évoluent souvent avec des ressources IT limitées. Elles doivent arbitrer entre robustesse, simplicité de maintenance et agilité. Cela implique :
- D’adopter une architecture évolutive permettant l’intégration rapide de nouvelles sources.
- D’assurer une traçabilité et une qualité de données sans faille pour la prise de décision.
- De favoriser un écosystème technique ouvert afin d’éviter le « vendor lock-in » et de préserver la capacité d’innovation.
Ces exigences structurent le choix des technologies et posent les bases d’une architecture cible adaptée aux spécificités des ETI.
Principes clés d’une architecture data open source
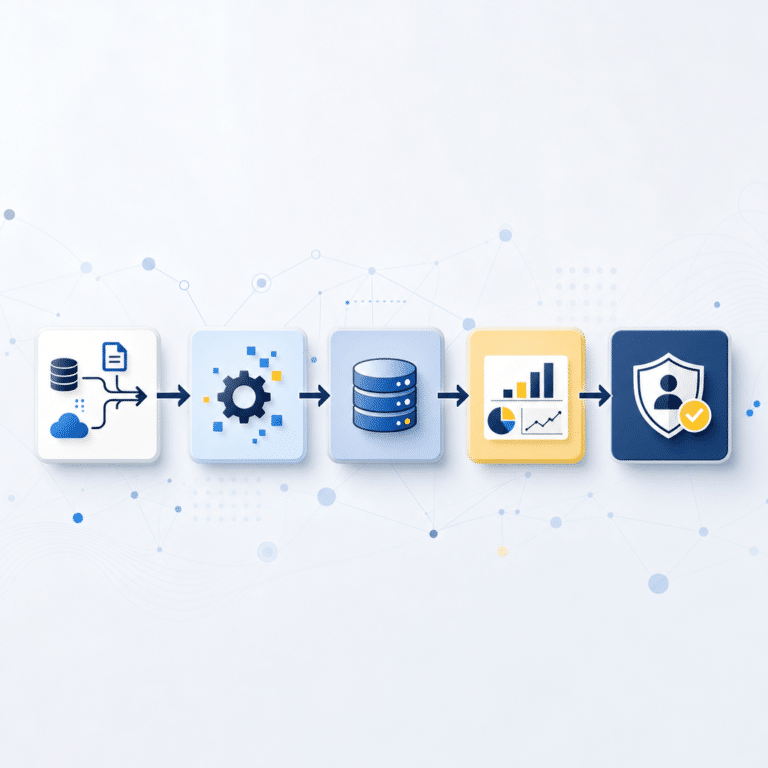
La construction d’une plateforme data moderne repose sur quelques principes incontournables, notamment lorsqu’on privilégie les technologies open source :
- Modularité : chaque brique (ingestion, traitement, stockage, BI, gouvernance) peut évoluer indépendamment.
- Interopérabilité : privilégier les formats, APIs et interfaces standards pour faciliter les échanges et l’intégration.
- Sécurité et gouvernance : intégrer dès l’origine la gestion fine des accès, des droits et la traçabilité des manipulations (Data Lineage).
- Automatisation : industrialiser les flux de données pour limiter l’intervention humaine et fiabiliser les processus.
Par exemple, une ETI du secteur industriel peut opter pour une stack open source associant Airbyte (ingestion ELT), DBT (transformation), PostgreSQL ou Apache Iceberg (stockage), Metabase ou Superset (BI), et un référentiel de données comme Amundsen ou DataHub pour la gouvernance. Ces composants adressent l’ensemble des étapes de la chaîne de valeur et favorisent une approche éprouvée « best of breed », sans dépendance éditeur.
Architecture cible : panorama des briques technologiques
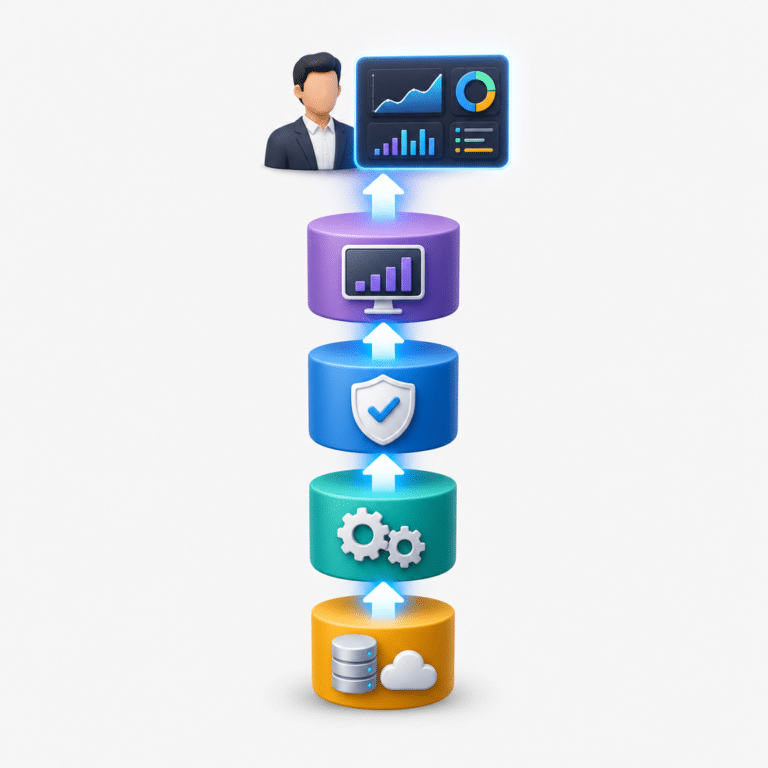
L’architecture idéale pour une ETI conjugue sécurité, évolutivité et maîtrise des coûts, tout en restant simple à maintenir. Voici une synthèse des principales briques :
- Ingestion de données : Airbyte, Fivetran (open source), Talend Open Studio pour collecter des données depuis les applications métiers, APIs et fichiers plats.
- Transformation et orchestrations : DBT, Apache Airflow, Luigi pour automatiser les traitements, appliquer les règles métiers et historiser les traceurs.
- Stockage : PostgreSQL, ClickHouse, Snowflake (si cloud souhaité, mais solution propriétaire), ou encore Apache Iceberg pour gérer un Data Lakehouse performant.
- Gouvernance et catalogue : DataHub, Amundsen pour documenter, tracer les flux et gérer les dictionnaires de données.
- Business Intelligence : Metabase, Apache Superset pour offrir des dashboards dynamiques accessibles aux métiers.
Par exemple, une ETI du secteur de la distribution peut tirer profit d’un pipeline automatisé Airbyte + DBT, des contrôles de qualité programmés (Great Expectations), et proposer un accès rapide aux données via Metabase. La capacité à monitorer les traitements, rejouer les flux et documenter la donnée contribue directement à la fiabilité et à la conformité des analyses produites.
Gouvernance et sécurité des données : un socle essentiel
Avec la croissance des usages, la gouvernance data n’est plus une option. Elle englobe :
- Le catalogage systématique des jeux de données, des flux et de leurs évolutions.
- La traçabilité des traitements, essentielle pour répondre aux audits et exigences réglementaires.
- La gestion intelligente des droits et des accès pour prévenir les risques de fuite ou de modification non autorisée.
Les solutions open source comme DataHub ou Amundsen rendent cette gouvernance accessible, y compris à des organisations ne disposant pas des moyens des grands groupes. Un bon exemple est celui d’une ETI du secteur pharmaceutique ayant implémenté un catalogue automatisé qui facilite le partage et le contrôle des données tout en réduisant la charge administrative pour les équipes IT.
N’oublions pas l’intégration native de la sécurité (Securité by Design) : chiffrement, audit des accès et anonymisation des données sensibles peuvent être mis en place rapidement grâce à des outils open source éprouvés, permettant de concilier conformité réglementaire et agilité des métiers.
Cas d’usage et exemples de déploiement
Voici quelques cas d’usages concrets où une architecture data open source adaptée a permis à des ETI d’accélérer la valorisation de leurs données métiers :
- Pilotage financier : automatisation de la consolidation budgétaire et génération de tableaux de bords dynamiques pour le contrôle de gestion.
- Optimisation des opérations : analyse en temps réel de la production et détection préventive des anomalies à partir de capteurs IoT.
- Suivi de la performance commerciale : centralisation des données multi-canaux pour affiner le ciblage marketing et accélérer la prise de décision.
Chez iiiData, nous observons que la réussite de ces projets tient à une démarche itérative : prototyper tôt, prioriser les cas d’usage à forte valeur, et appuyer la montée en compétence des équipes internes. Cela garantit l’appropriation, la pérennité de la plateforme et la montée en puissance progressive de l’organisation sur ses enjeux data.
Pour les ETI, bâtir une architecture data moderne et ouverte n’est plus réservé aux géants du numérique. Les solutions open source permettent aujourd’hui d’industrialiser l’accès à la donnée, d’offrir une gouvernance robuste et d’accélérer la valorisation métier tout en gardant la main sur les coûts et l’évolutivité. L’accompagnement de partenaires expérimentés comme iiiData facilite le passage à l’échelle, la sécurisation des projets et la montée en autonomie de vos équipes. Un enjeu-clé pour transformer durablement votre organisation par la donnée.
📚 Pour aller plus loin
- Documentation officielle Airbyte
- Documentation DBT
- Projet open source DataHub (catalogue de données)
- Guide officiel Apache Superset
- Documentation Great Expectations (qualité de données)

Transformez vos données en avantage concurrentiel.
iiiData accompagne les PME, ETI et grands groupes dans la conception de plateformes Data, BI, IA et automatisation basées sur les meilleures technologies Open Source.
Architecture • Data Engineering • BI • IA • Formation